最近我一直在做一个新的开源项目:JevSec。
它不是一个“AI WAF”,也不准备替代传统 WAF。更准确地说,JevSec 想解决的是另外一层问题:
WAF 更擅长看一条请求里有没有危险内容,而 JevSec 想看一段时间里,这个客户端整体在做什么。
一句话概括:
Your WAF sees requests. JevSec sees behavior.
为什么会有这个想法
传统 WAF 很成熟。SQL 注入、XSS、路径穿越、命令注入这类带明显请求特征的攻击,本来就是成熟规则集擅长的领域。
但另一类问题没有那么容易只靠一条请求判断。例如:正常访问 → 连续探测多个路径 → 多次登录失败 → 某次登录成功 → 随后访问敏感接口。每条请求单独看可能都没有典型攻击 payload,真正可疑的是顺序、频率和上下文组合起来后的行为。
所以我开始尝试把请求先聚合成短时间的 behavior window,再交给规则与本地小模型一起判断。
JevSec 现在怎么工作
当前链路是:Nginx / JSONL → 隐私化解析 → IP / Session 行为窗口 → 静态规则 + 本地 Qwen3-4B → BENIGN / REVIEW / HIGH_RISK / UNCERTAIN → SQLite + Dashboard。
目前只支持一个本地模型:Qwen3-4B。模型通过本地 Jev 兼容服务运行,目标一直是 self-hosted,而不是把日志直接发到云端。
为了减少敏感信息进入模型,JevSec 不保留 Cookie、Authorization、密码、API Key 等字段。模型上下文主要由白名单聚合指标和行为特征组成。
为什么坚持 shadow mode
目前 JevSec 不自动 block、不改防火墙、不自动 ban IP,也不把模型输出当最终结论。它更像一个“多看一层”的复核系统。
对安全产品来说,漏报麻烦,误报同样麻烦。模型分数稍微高一点就直接封请求,这种设计在真实环境里很难让人放心。
半真实 benchmark:结果没有想象中漂亮
前期我在合成行为数据上跑过一些不错的数字,但合成数据可能太像设计者希望它长成的样子,所以后来加入 CSIC 2010 HTTP 数据集做半真实 replay benchmark。
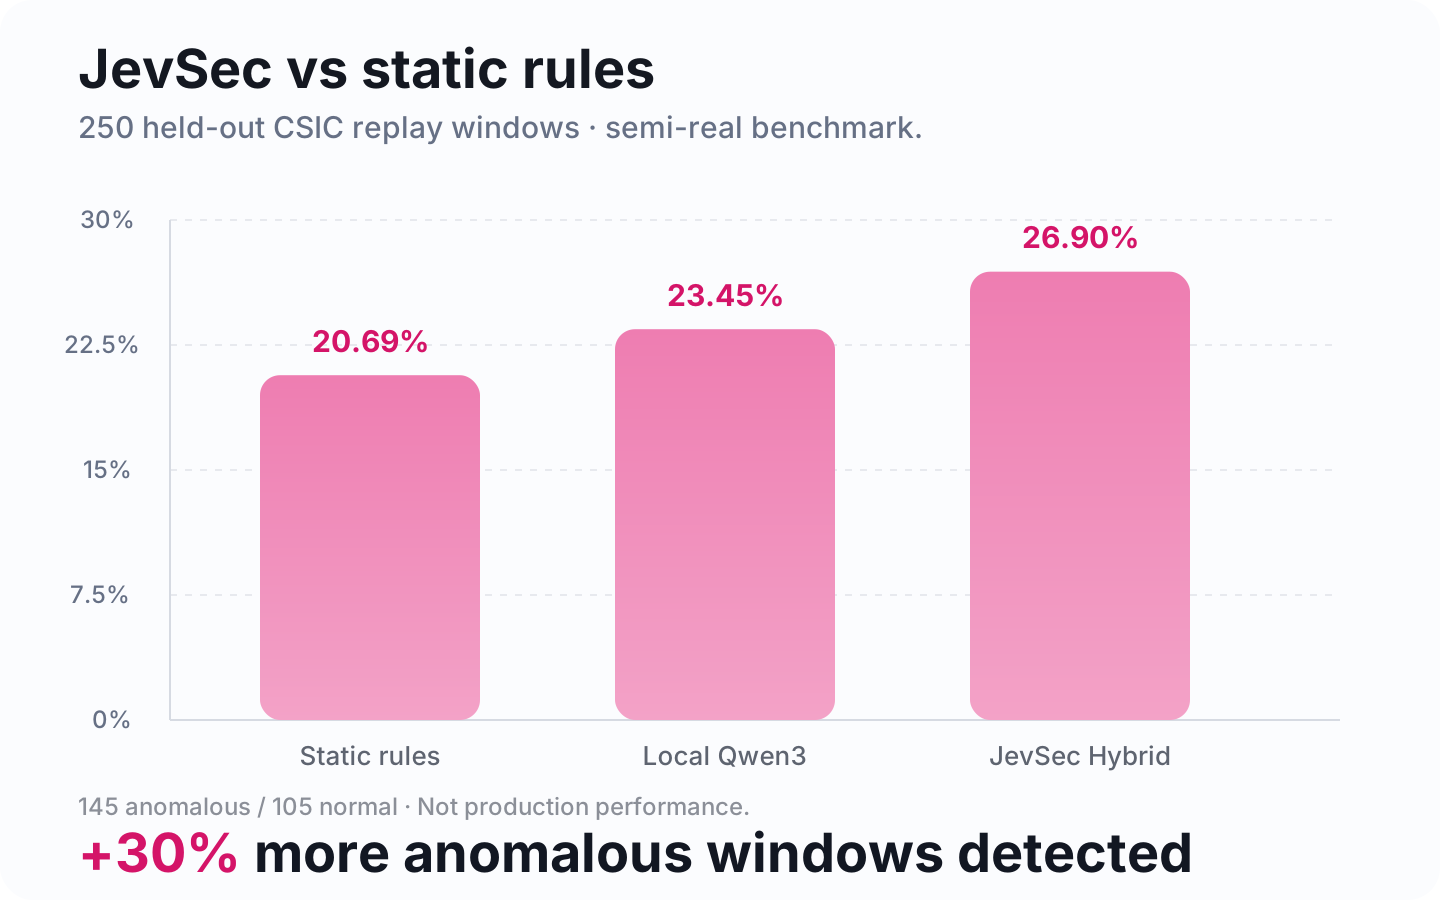
当前核心测试样本是 250 个独立测试窗口,其中 145 个标记异常、105 个正常,每个窗口 12 条请求,一部分异常窗口只混入 1~3 条异常请求。
| 方案 | Recall | Precision | 观察到的 FPR | 检出的异常窗口 |
|---|---|---|---|---|
| 静态规则 | 20.69% | 100.00% | 0.00% | 30 / 145 |
| Qwen3-4B | 23.45% | 97.14% | 0.95% | 34 / 145 |
| JevSec Hybrid | 26.90% | 97.50% | 0.95% | 39 / 145 |
最直观的数字是:Hybrid 抓到 39 个异常窗口,而静态规则抓到 30 个。 在这一小批测试数据上,检出数量相对增加约 30%,代价是在 105 个正常窗口里多送了 1 个去复核。
只看“一个异常请求混在正常请求里”的低强度场景,静态规则 Recall 为 16.67%,Qwen3-4B 为 20.83%,Hybrid 为 25.00%。
但 AUROC 很差
如果只看 Recall,很容易觉得模型已经很强。但我不想只挑好看的数据。
这一轮风险分数 AUROC:静态规则 0.522、Qwen3-4B 0.473、Hybrid 0.454。
这说明模型目前还没有形成稳定的风险排序能力。现在的提升更多来自校准后的 review 工作点,而不是一个优秀的全局风险排序器。
所以这份数据只支持一个很窄的结论:
在这套 held-out CSIC replay 样本里,Hybrid 的确额外捞到了一些规则漏掉的异常窗口,但还不能据此证明它已经具备生产环境里的未知攻击检测能力。
JevSec 和 OWASP CRS 的关系
我现在越来越明确的一点是:不要让 JevSec 跟成熟 WAF 抢它最擅长的工作。
SQLi、XSS、路径穿越这类典型 payload 交给 CRS。JevSec 更应该处理跨请求顺序、低速枚举、登录前后状态变化、路径访问模式突变、Session / User 级行为变化,以及规则和模型不一致时的复核。
未来更合理的 Hybrid,不是简单做规则分和 AI 分的加权平均,而是让 WAF 负责明确请求级命中,让 JevSec 处理跨请求上下文和不确定区域。
下一步:Sequence Context
现在最大的问题之一,是把行为压成统计量后可能丢掉很多顺序信息。
“登录失败 → 登录失败 → 登录成功 → 敏感访问”和“正常访问 → 登录成功 → 普通浏览 → 偶尔失败”,计数可能接近,但安全含义完全不同。
所以下一步会把上下文进一步改成隐私安全的事件序列,而不是只给模型一堆 count。最核心的验证目标也很简单:加入真正的 sequence context 后,AUROC 能不能明显离开 0.5。
如果仍然不行,那就应该认真考虑 Qwen3-4B 是否适合做核心排序器,还是更适合退到辅助解释和复核层。
为什么坚持本地 4B 模型
我不想用最大的模型做最好看的 benchmark。我更想知道:一个普通开发者能在自己的 Mac 或本地服务器上运行的小模型,到底能不能为已有安全栈提供一点真正有用的增量。
如果最后证明 4B 模型不够,那也是结论;如果它在正确的上下文设计下能稳定提供增益,那这个方向就会很有意思。
现在可以怎么玩
JevSec 目前还是 Research Alpha。仓库已经公开 benchmark、WAF 对比、失败分析、隐私设计和 threat model。
如果你做 Web 安全、SOC、WAF、Nginx 日志分析,或者也在研究本地小模型做安全决策,欢迎直接看代码、跑 benchmark、提 Issue。
我现在最想收到的不是“这个项目好厉害”,而是:benchmark 设计哪里有问题、哪些正常行为特别容易误报、哪些跨请求攻击链应该优先加入、哪些特征不应该进入模型,以及怎样才能更公平地证明它到底有没有用。
最后
JevSec 现在还没有资格说自己“重新定义 WAF”。
它目前只是一个问题:
如果不只看一条 HTTP 请求,而是看一段完整行为,本地小模型能不能帮传统规则多发现一些值得人类注意的东西?
现在的答案是:好像可以多发现一点,但离真正证明还有很远。
这也是接下来继续做它的理由。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文