如果一个 AI 安全模型告诉你某个 IP 有 82% 概率是恶意的,你会直接封它吗?
我不会。
至少现在不会。
这也是 JevSec 从第一版开始一直坚持 Shadow Mode 的原因。
项目地址:GitHub
AI 安全最容易走错的一步
很多安全 Demo 很喜欢做模型判断恶意之后自动封 IP。
因为演示效果很好。
但真实生产环境里,最难的问题不是让模型输出一个 risk score,而是如果它错了怎么办。
搜索引擎爬虫、正常批量 API 客户端、内部自动化、压测、监控系统、新版本前端行为、某个大型客户的特殊访问模式,都可能看起来非常异常。
如果模型直接参与 enforcement,误报就不再只是 dashboard 上的一个红点,而会变成业务事故。
所以 JevSec 目前只旁路看日志
当前设计是 Nginx 或 WAF 保持主链路,JevSec 从 access log 旁路读取行为,再聚合成 Behavior Window,交给 Rules 和 Qwen 分析,最后输出 REVIEW、HIGH_RISK 或 UNCERTAIN。
JevSec 不改变主流量链路。
这意味着即使模型挂了,网站继续正常工作。
即使模型误报,用户也不会被自动封禁。
这对研发阶段特别重要
当前 JevSec 的 benchmark 还远不够强。
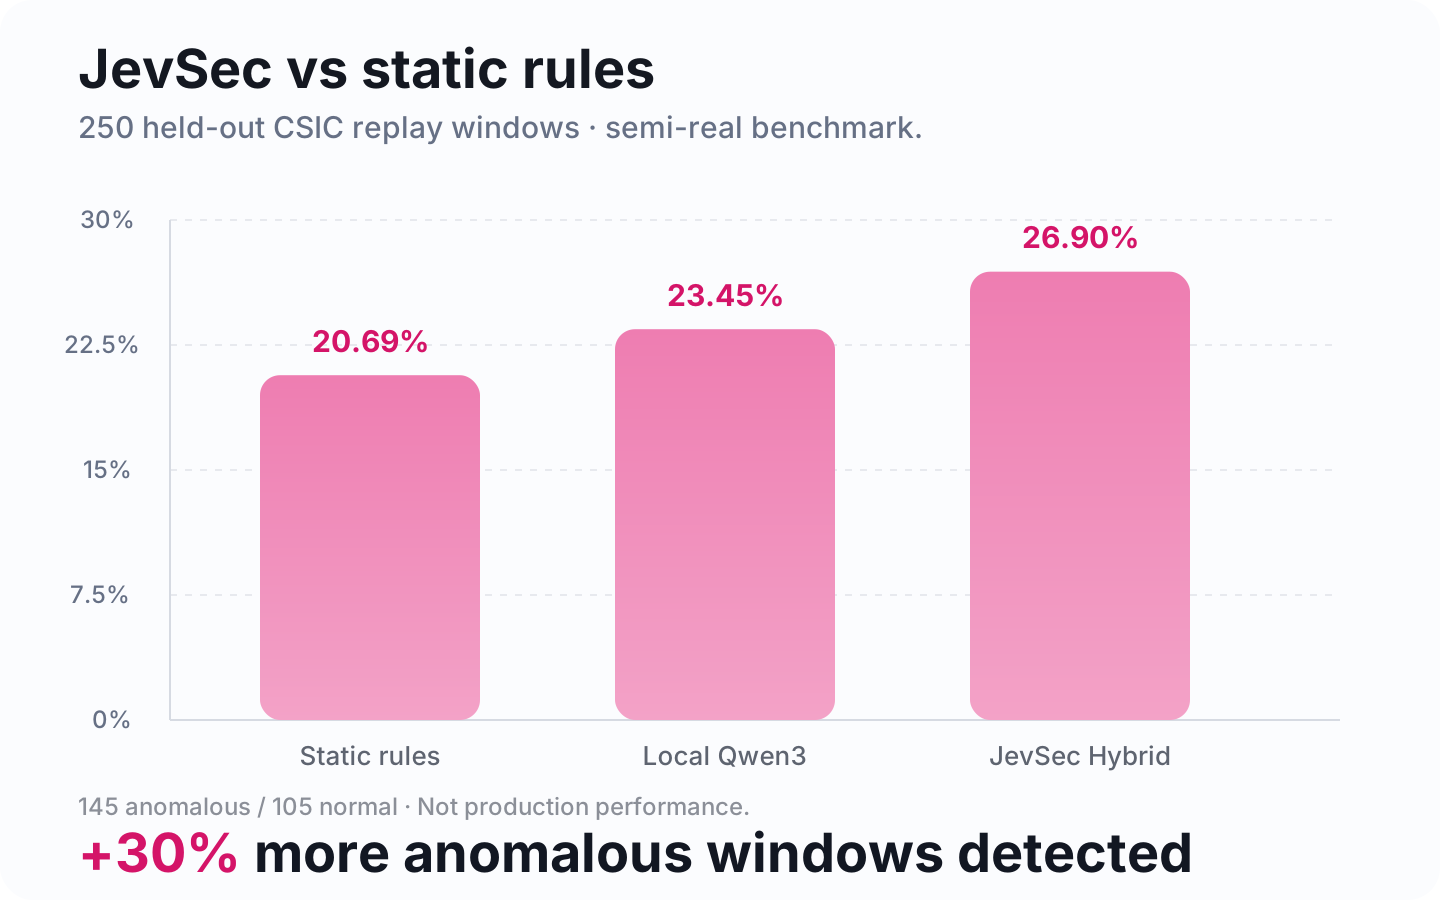
在半真实 250-window 测试里,Hybrid Recall 是 26.90%,Precision 是 97.50%,Observed FPR 是 0.95%。
但更关键的是 Hybrid AUROC 只有 0.454。
这说明风险排序本身仍然很弱。
在这种阶段,如果还让它自动 block,其实是在掩盖工程风险。
Shadow Mode 能带来什么
Shadow Mode 最大的价值,是获得真实反馈而不影响业务。
运行一段时间后,可以统计每天产生多少 Review、哪些正常行为最容易误报、规则和模型在哪里冲突、哪些高风险事件最终被人工判定正常、模型延迟,以及行为窗口大小是否合理。
这些信息才是真正能让系统进化的数据。
什么时候才应该讨论自动拦截
至少应该经过多个真实环境的长期 shadow 验证,对 false positive 有稳定估计,有明确 rollback,决策理由可审计,高风险动作有更严格 gate,而且模型失效时能安全回退到传统规则。
甚至最后也不一定需要全自动。
更现实的模式可能是低风险只记录,中风险 Review,高风险加 deterministic evidence 才自动限流,极高风险且明确 WAF 命中才进入 enforcement。
Nginx 为什么适合做第一入口
Nginx access log 是一个很实用的起点。
它接入简单,不需要改业务代码,有路径、状态码、时序等基础信息,而且天然适合旁路。
当然它也有明显限制。
默认 Combined Log 并不包含完整 request body,所以 JevSec 不能假装天然能看到所有 SQLi 和 XSS payload。
如果生产里确实需要 body-level signal,就应该通过经过审查的安全解析器或 WAF signal 接入,而不是把所有 body 随便记录下来。
我更希望 JevSec 成为第二双眼睛,而不是一个拿着封禁按钮、但自己还不够稳定的 AI。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文