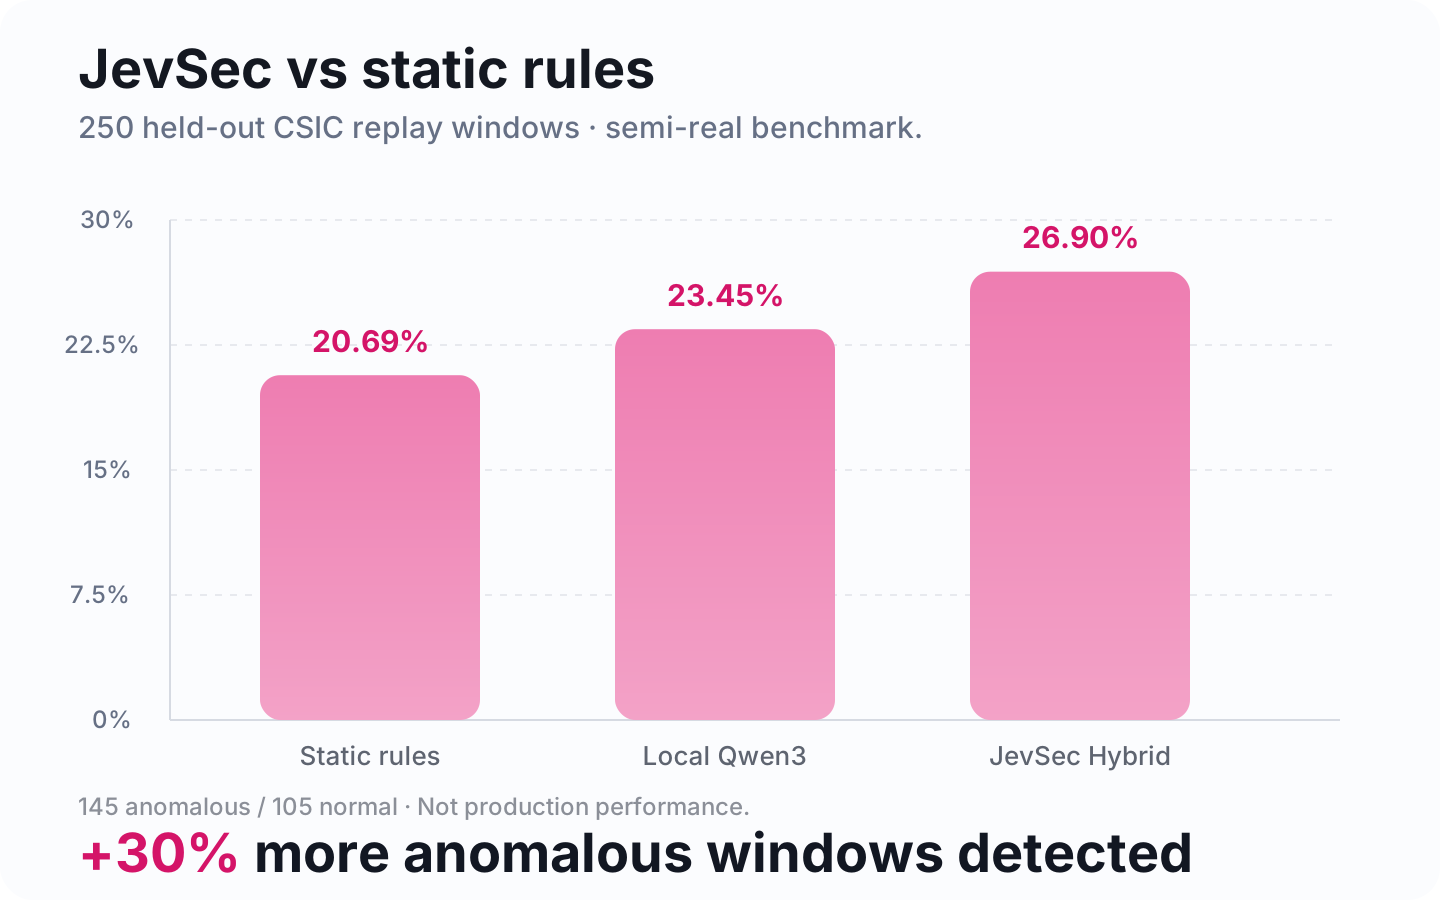
JevSec 最新 benchmark 出来之后,我认为下一步最重要的事情已经不是继续调 threshold。
而是重新设计模型到底看到了什么。
项目地址:GitHub
现在的问题:统计量可能把最重要的信息丢了
当前系统会对一个时间窗口做聚合。
例如一个窗口可能只有这些数字:请求总数、登录失败次数、唯一路径数量、敏感路径数量和高编码请求数量。
这种表示很适合规则,也很适合传统分类器。
但行为安全很多时候取决于顺序。
失败登录、失败登录、成功登录、敏感访问,和正常访问、成功登录、普通浏览、偶尔失败,统计量可能很接近,安全含义却完全不同。
所以 v0.3 想做 Sequence Context
我准备把每条请求先转换成隐私安全的事件符号。
例如:
- NORMAL_PATH
- NEW_PATH
- LOGIN_FAIL
- AUTH_SUCCESS
- SENSITIVE_PATH
- HIGH_ENCODING
- BURST_ACCESS
- ENUMERATION_PATTERN
这样模型看到的不再只是 login_failure_count 等统计量,而是一串真正有顺序的信息。
例如:
NORMAL_PATH → LOGIN_FAIL → LOGIN_FAIL → AUTH_SUCCESS → NEW_SENSITIVE_PATH
这样模型才真正有机会判断前后发生了什么变化。
为什么不是直接把 URL 发给模型
真实 URL 往往包含大量业务信息和用户数据。
即使是本地模型,也没有必要把所有原始信息长期保存。
所以 Sequence Context 的关键不是更多原始数据,而是保留顺序、减少内容。
路径可以映射成 KNOWN_PUBLIC_PATH、NEW_PATH、SENSITIVE_PATH、RARE_PATH。
身份可以映射成 SAME_SESSION、NEW_SESSION、AUTH_STATE_CHANGE。
响应可以映射成 SUCCESS、AUTH_FAIL、FORBIDDEN、ERROR_SPIKE。
这样既保留行为结构,又尽量减少隐私暴露。
模型任务也需要简化
我现在不太想继续让 4B 模型一次完成分类、severity、unknown attack 判断、risk score、explanation 和 action recommendation。
对于一个小模型,更合理的是拆开。
第一问:这个窗口是否值得人工复核?
第二问:如果值得复核,大概属于 auth anomaly、enumeration、exploit-like、automation、unusual navigation 还是其他?
第三步再生成解释。
这样风险排序和解释不会混在一起。
我真正想看的指标
Sequence Context 做完以后,我最关注的是 AUROC、低 FPR 条件下的 Recall、low-intensity scenario,以及真正的 sequence-only anomaly。
当前 Qwen AUROC 是 0.473。
如果新的 sequence representation 连 0.6 都上不去,我会开始怀疑 Qwen3-4B 是否适合做核心 ranking。
如果还是失败怎么办
那也很清晰。
架构可以改成 temporal classifier 负责 risk score,Rules 和 WAF 提供确定性 signal,Jev 负责结构化决策,Qwen3-4B 退到 explanation 和 review 层。
Qwen 不一定非要当 classifier。
它可以做自己更擅长的上下文解释。
JevSec 不是为了证明大模型什么都能做,而是在寻找 LLM 在真实安全系统里到底应该放在哪一层。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文