如果只是追求 benchmark,最简单的方法通常是换更大的模型。
但我做 JevSec 时反而故意把模型限制在了 Qwen3-4B。
项目地址:GitHub
为什么?
因为我真正想验证的问题不是最强大模型能不能做安全分析,而是一个普通开发者能本地跑起来的 4B 模型,到底能不能给现有安全系统提供有意义的增量。
为什么一定要本地
Web 安全日志本身非常敏感。
里面可能包含用户路径、Session 关联、请求参数、内部接口、鉴权状态和业务行为模式。
即使经过脱敏,很多团队仍然不愿意把这类信息直接发给第三方云模型。
所以 JevSec 的设计原则一直是先假设数据不应该离开本机。
本地不等于把所有日志直接喂进去
如果把完整 HTTP 日志直接送进模型,本地也一样有问题。
上下文成本高、推理会变慢、模型容易被无关文本干扰,而且输入格式难控制。
所以 JevSec 当前先进行 privacy-aware normalization。
Cookie、Authorization、Password、API Key 等敏感值不会保留到模型上下文里,Session 和 User 标识也会做伪匿名化。
模型主要看到白名单行为特征。
4B 的优势
第一是部署简单。普通 Apple Silicon 或带一定显存的机器就有机会运行。
第二是延迟可接受。当前 Qwen3-4B 单次行为窗口判断在秒级附近,对 inline WAF 来说太慢,但对 shadow-mode triage 是可以讨论的。
第三是成本固定,没有按 token 增长的云 API 费用。
第四是数据控制更清晰,日志可以留在自己的环境。
4B 的问题也很明显
最新半真实测试把它暴露得很彻底。
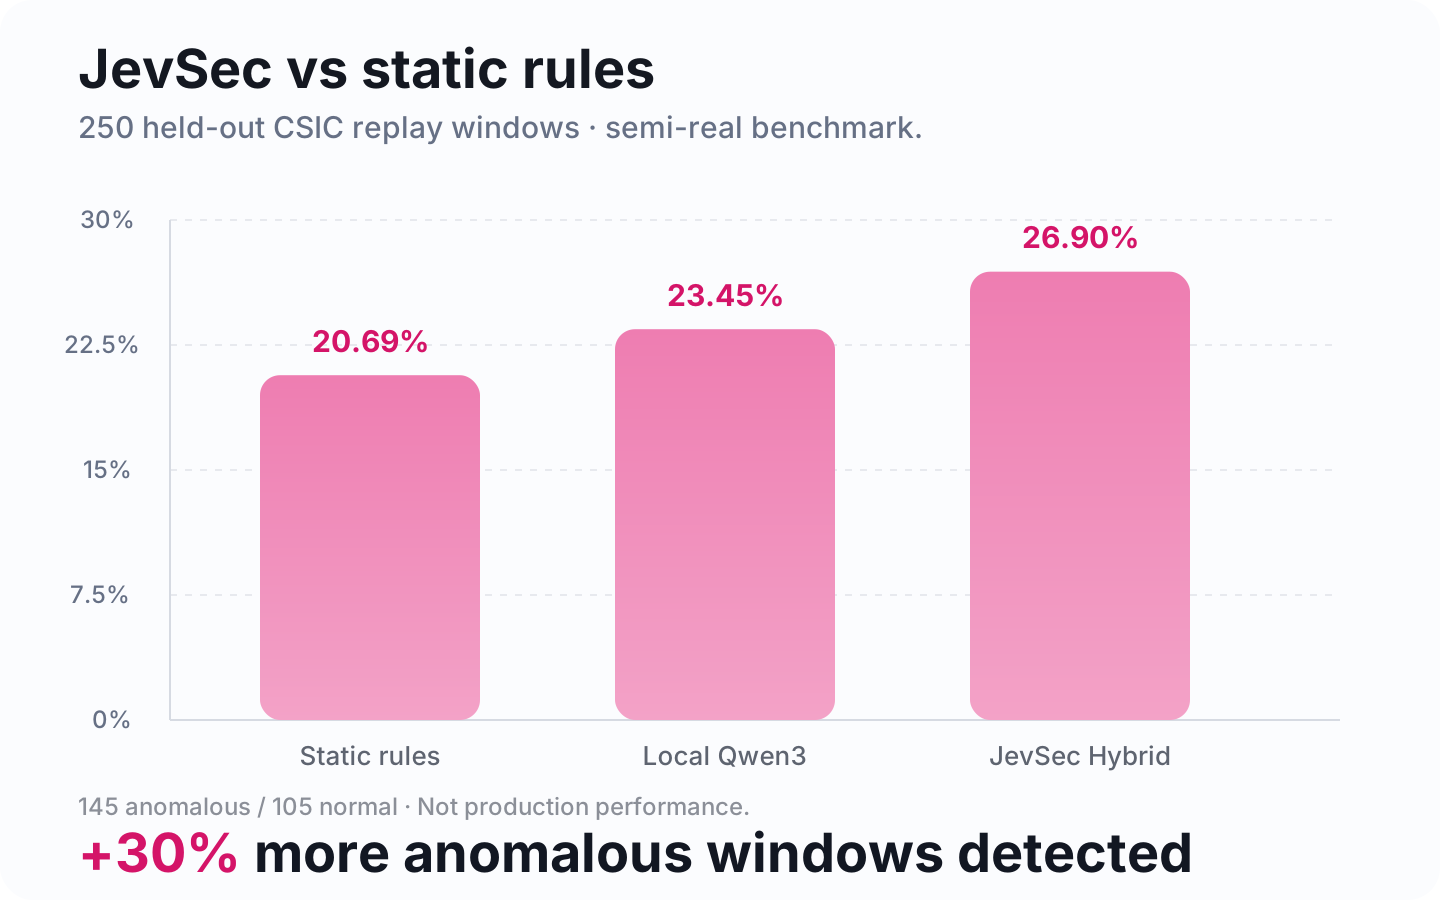
当前 250 个 held-out 窗口:
- Rules Recall:20.69%
- Qwen Recall:23.45%
- Hybrid Recall:26.90%
看起来 Qwen 有一点帮助。
但 Qwen AUROC 只有 0.473。
这说明它目前并不是一个可靠的风险排序器,某些异常窗口甚至会得到较高 benign confidence。
这不是换一个 threshold 就能彻底解决的。
为什么暂时不换 14B 或 32B
因为如果现在马上换大模型,我就无法回答一个关键问题:
问题到底是模型大小不够,还是 Context 设计本身就错了?
当前系统会把很多行为压缩成统计特征。
如果输入表示本身已经丢失了失败登录、成功登录、敏感访问之间的顺序关系,那么换成更大的模型,也可能只是更聪明地分析一个不完整输入。
所以我更想先把 Sequence Context 做好。
我真正想验证的边界
下一步我想回答:
- Qwen3-4B 在隐私安全的 sequence representation 下能不能明显提升 AUROC?
- 4B 的瓶颈到底出现在 classification、ranking 还是 explanation?
- 是否应该让专门的 temporal classifier 做风险排序,让 Qwen 只负责解释和复核?
- 本地小模型和 WAF signal 融合后能不能保持低误报?
如果答案最后是 4B 不适合作为核心 classifier,那 JevSec 也可以变成专门分类模型加 Jev 决策层,再由 Qwen3-4B 负责解释和复核。
这仍然是有价值的结果。
本地小模型真正有意思的地方,可能不是接管安全系统,而是在已有规则系统旁边增加一个便宜、可控、私有的推理层。
它不需要什么都做。
只要能稳定把一部分传统规则难以表达的行为推到人工面前,就已经有价值。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文