做 AI 安全项目时,有一件事特别危险:
Benchmark 可以非常容易地变漂亮。
尤其当数据也是自己生成的时候。
JevSec 前期也经历过这个阶段。
项目地址:GitHub
一开始的数据其实很好看
早期 synthetic benchmark 里,Qwen3-4B 和 Hybrid 的 Recall、F1 都相当不错。
当时很容易产生一种错觉:这个东西是不是已经能明显补规则系统了?
但后来我越来越意识到一个问题。
如果行为模板是我自己设计的,模型可能只是在识别我设计出来的模式。
当我人为规定多次 auth failure 是危险、路径增长是危险、请求频率突然提升是危险,模型最后学到的可能不是安全行为,而是我对安全行为的定义。
所以后来加入了 CSIC replay
为了让测试更难一点,我加入了 CSIC 2010 HTTP 数据。
它并不完美,它很老,而且本身也是实验生成数据。
但它至少能提供大量 HTTP 请求形态,让我不再完全依赖自己写的行为模板。
当前构造方式是每 12 条请求形成一个窗口。正常窗口来自 normal pool,异常窗口混入 1 到 3 条 anomaly request。验证集和测试集实体互斥,阈值只允许在 validation 上选择,test 只做最终评估。
结果一下没那么漂亮了
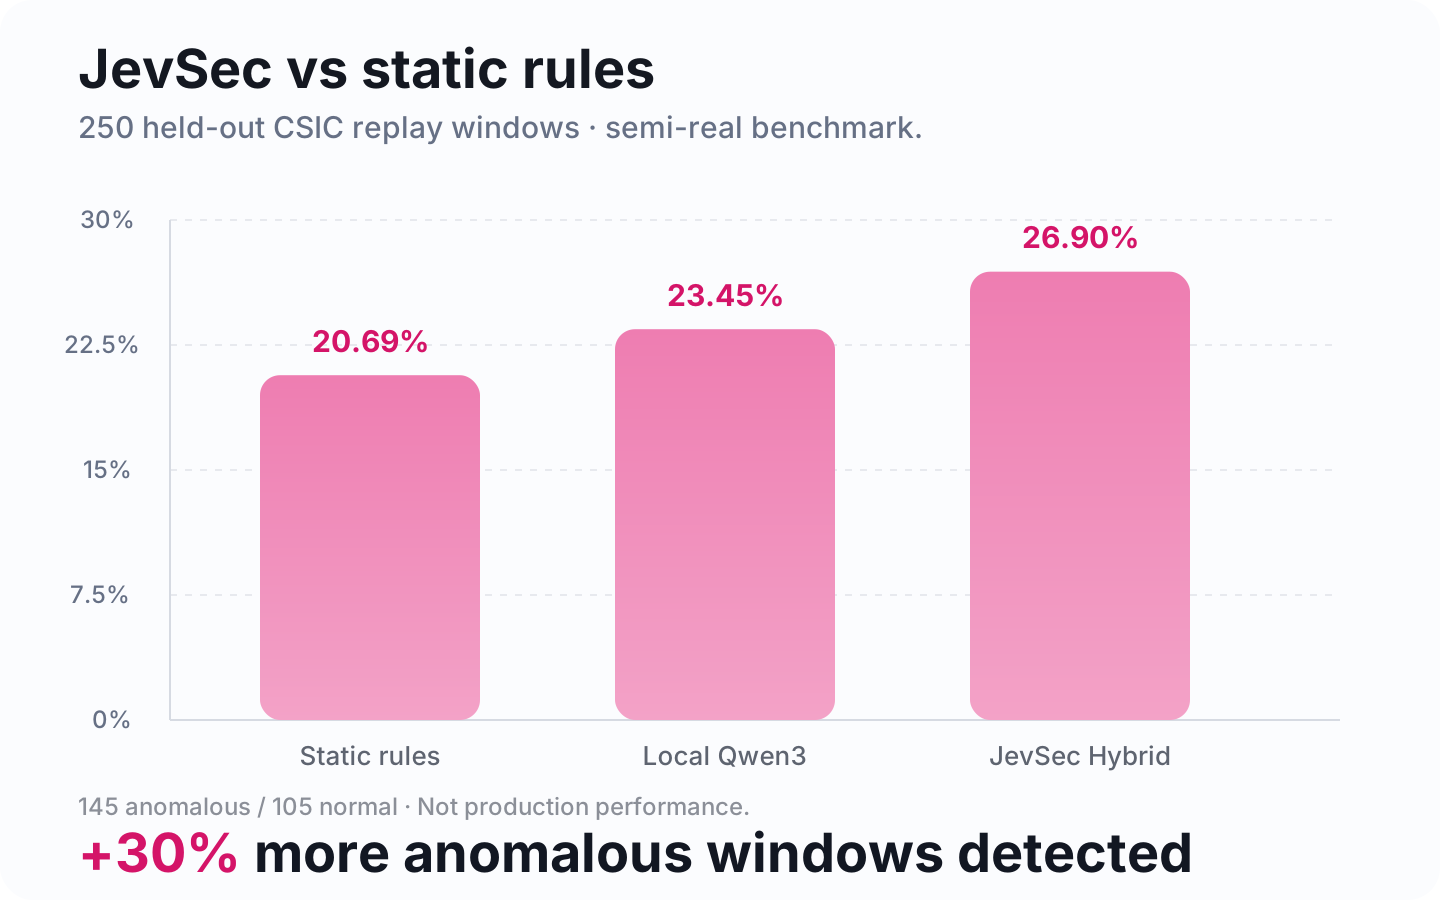
当前核心 250-window 测试:
| 方案 | Recall | FPR | Precision | Detected |
|---|---|---|---|---|
| Rules | 20.69% | 0.00% | 100.00% | 30 / 145 |
| Qwen3-4B | 23.45% | 0.95% | 97.14% | 34 / 145 |
| Hybrid | 26.90% | 0.95% | 97.50% | 39 / 145 |
如果只看这一张表,其实还挺好看。
Hybrid 从 30 个异常窗口提高到 39 个,检出数量相对增加约 30%。
但继续看 AUROC:
- Rules:0.522
- Qwen:0.473
- Hybrid:0.454
问题就出来了。
AUROC 低于 0.5 意味着什么
如果一个风险分数真的有用,异常样本的分数应该总体高于正常样本。
AUROC 越接近 1,这种排序关系越稳定。
接近 0.5,说明排序接近随机。
因此当前 JevSec 的一些 Recall 提升,并不是因为模型建立了一个很好的风险排序空间,更多是因为校准后的 review 工作点捞到了一些额外异常。
这两个结论完全不同。
为什么我把差指标也放 README
从宣传角度看,最简单的方法当然是只写加 30% detections,然后不写 AUROC。
但安全项目如果连失败指标都不敢放出来,别人认真复现一次之后信誉就没了。
所以现在 README 第一屏强调 39 vs 30,同时下面直接公开 Hybrid AUROC 0.454。
我反而觉得这会让项目更可信。
Test Set 不能拿来反复调
另一个非常重要的问题是 test leakage。
已经看过测试结果之后,如果不停换 threshold,然后挑一个最好看的数,test 就已经失去意义。
所以 JevSec 现在坚持:
- threshold 只在 validation 上选
- test 只用于最终评估
- 需要继续优化时建立新的 holdout
- benchmark 保留完整 FP 和 FN
- 不因为 false positive 难看就删除样本
我现在最关心的不是 Accuracy
对安全 triage 来说,我更关注 Recall、FPR、Review Rate、AUROC、分场景 Recall,以及具体哪些 FP 和 FN 失败。
因为一个项目真正有没有研究价值,不是看最好的一张表,而是看它到底在哪里失败,失败是否可解释,以及下一版是否真的修到了这些失败。
下一轮我会把重点继续推向 sequence-only anomaly,也就是每条请求单看都正常,但组合起来异常。
如果 Sequence Context 做完以后 AUROC 仍然在 0.5 左右,那就应该承认 Qwen3-4B 可能不适合做核心风险排序器。
这不是坏结果。
这恰恰是 benchmark 应该告诉我们的东西。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文