我做 JevSec 的过程中,最容易被问到的一个问题是:
既然有 OWASP CRS 这种成熟 WAF,为什么还要做一个 AI 安全引擎?
答案其实很简单:它们看的不是同一层东西。
项目地址:GitHub
WAF 更擅长看一条请求
传统 WAF 的核心工作对象通常是一条 HTTP 请求。
例如参数里有没有 SQL 注入特征、请求体有没有 XSS、路径里有没有目录穿越、是否命中了危险编码模式、是否触发了某个规则 ID。
这些问题非常适合规则系统。
成熟规则集经过多年积累,在 request-level exploit syntax 这类任务上,本来就应该比一个 4B 小模型稳定。
所以 JevSec 从一开始就不应该把目标定成让 Qwen3-4B 代替 OWASP CRS。
JevSec 想看的是一段行为
真正让我觉得有意思的是另一类情况。
例如一个客户端先访问首页,再进入登录页,连续失败数次,随后突然登录成功,然后访问之前没访问过的敏感路径,并在短时间请求多个接口。
如果每条请求单独拿出来看,很多都可能完全正常。
但放进同一个时间窗口之后,顺序、频率、状态变化和上下文组合起来就开始可疑。
这就是 JevSec 想处理的东西:
- 顺序
- 频率
- 路径变化
- Session 状态变化
- 登录前后行为
- 多个弱信号组合
- 规则与模型之间的分歧
一句话:
Your WAF sees requests. JevSec sees behavior.
为什么坚持 Shadow Mode
如果 JevSec 现在根据模型输出直接自动封 IP,我认为那是不负责任的。
当前系统仍然有明显限制:半真实 benchmark 规模不大、AUROC 仍然很弱、某些异常窗口会被模型高置信判断 benign、真实生产流量还没有大规模验证。
所以现在最合理的部署方式是旁路读取日志,输出 REVIEW、HIGH_RISK 或 UNCERTAIN,再由人分析。
WAF 保持 enforcement,JevSec 负责 triage。
Hybrid 不应该只是两个分数加权
很多 AI 安全产品喜欢把规则分和模型分简单相加。
但两个系统擅长的是不同任务。
我更希望未来的 JevSec 是:
- 明确 exploit signature:WAF 或规则主导
- 明确行为规则命中:高优先级复核
- 模糊跨请求行为:Qwen3-4B 分析上下文
- 规则和模型明显冲突:进入 UNCERTAIN 人工复核
这比简单的加权平均更接近真正的互补关系。
当前数据说明了什么
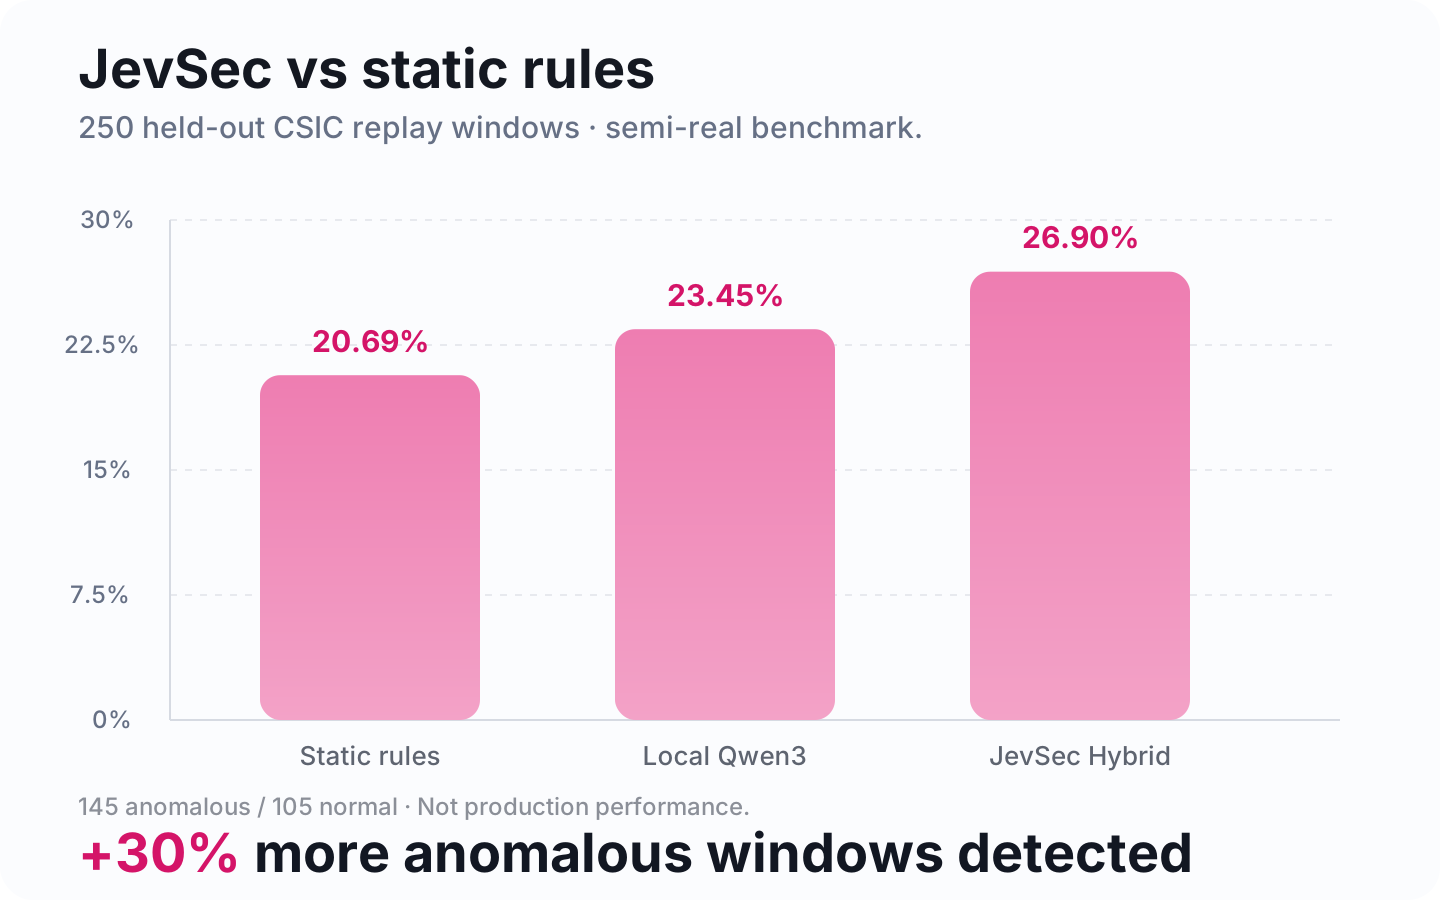
最新 250 个 held-out 半真实窗口中:
| 方案 | Recall | Precision | Observed FPR |
|---|---|---|---|
| 静态规则 | 20.69% | 100.00% | 0.00% |
| Qwen3-4B | 23.45% | 97.14% | 0.95% |
| Hybrid | 26.90% | 97.50% | 0.95% |
Hybrid 抓到 39 个异常窗口,规则抓到 30 个。
但 AUROC 仍然是 Rules 0.522、Qwen 0.473、Hybrid 0.454。
所以当前结论不是 AI 比 WAF 强,而是行为层在这套 replay benchmark 里带来了一点额外 coverage,但风险排序还远没有成熟。
我认为正确的产品位置
未来如果 JevSec 真正有价值,它应该是:
WAF 负责请求级第一道防线,JevSec 负责行为级第二双眼睛,SIEM 和 SOC 再负责更长时间尺度的调查。
不是互相替代,而是不同时间尺度、不同抽象层次一起工作。
这也是为什么我现在更愿意把 JevSec 描述成 Behavioral Security Triage Layer,而不是 AI WAF。
发现错误,或想补充改进这篇文章?
在 GitHub 上编辑此文